
Современные методы обработки текстов открывают новые горизонты для изучения многогранных смыслов. Один из таких подходов включает в себя создание групп связанных терминов и фраз, которые образуют единый смысловой блок. Этот метод позволяет не только сохранить контекст, но и выявить скрытые значения слов и выражений в процессе локализации контента.
Для оптимальной адаптации информации для аудитории необходим глубокий анализ культурных и языковых особенностей. При этом следует учитывать не только лексические, но и синтаксические аспекты. Использование синонимов и аналогов помогает передать задуманный автором смысл, позволяя избежать буквального перевода и улучшая читаемость.
При создании смысловых групп рекомендуется использовать как общепринятые, так и специализированные термины, что может значительно повысить точность и качество перевода в целом. Разработка стратегий для работы с такими концепциями поможет избежать недоразумений и обеспечит соответствие ожиданиям конечной аудитории.
Что такое кластер в контексте перевода?
Система, объединяющая схожие запросы и темы, представляет собой структурированное представление, которое помогает организовать информацию. Такой подход позволяет улучшить качество результатов, так как учитывает взаимосвязи между терминами и выражениями.
Классификация осуществляется по нескольким критериям:
- Тематика: сводит схожие области, например, технический и художественный контексты.
- Степень сложности: определяет уровень сложности текстов, выделяя простые и специализированные варианты.
- Целевая аудитория: учитывает предпочтения конечного пользователя, создавая материалы, которые легче воспринимаются.
Организация такой структуры позволяет авторам изучать группы слов, которые часто встречаются вместе, что способствует более точной интерпретации в рамках заданного контекста. Это особенно полезно при работе с большими объемами информации.
Существуют несколько рекомендаций для эффективного использования данной структуры:
- Создание библиотеки терминов, где собраны наиболее употребляемые словосочетания и их варианты.
- Регулярное обновление данных для отражения изменений в актуальной терминологии.
- Использование специальных программных решений для автоматизации процесса анализа.
Подход, основанный на объединении тематических групп, способствует созданию более качественных и адаптированных текстов. Это обеспечивает лучшую совместимость материалов и удовлетворение ожиданий пользователей. Применение данной методологии улучшает восприятие и запоминание информации.
Применение кластеров в машинном переводе
В современных системах автоматической трансформации текстов внедрение группировки данных позволяет значительно повысить качество конечного результата. Основная цель – агрегация информации для более точного выполнения заданий. С помощью кластеризации данных удается сбор характеристик, что приводит к формированию контекстуальных моделей.
Одним из примеров использования групп является анализ и структурирование больших объемов текстов. На основе таких полей, как тематика, стиль и сложность, формируются группы, что обеспечивает более точное соответствие при генерации новых фраз. Это позволяет системе лучше различать нюансы между разными значениями слов и выражений.
Для улучшения синхронизации между различными компонентами системы возможно применение методов машинного обучения. Обучение на распроустраненных комбинациях слов помогает выделить наиболее успешные примеры и создавать обширные базы данных, что позволяет значительно сократить время обработки заявок.
Еще одним направлением является использование кластеров для определения семантических связей между фразами. Группировка по схожести помогает системе лучше понимать контекст, результаты чего влияют на качество и естественность формируемых текстов. В этом процессе важным становится отбор ключевых слов, что позволяет системам более точно реакционировать на запросы пользователей.
Для достижения максимальных результатов целесообразно применять гибридные подходы, комбинируя классические алгоритмы с нейросетевыми методами. Это позволяет улучшить алгоритмы обучения и повысить точность результатов. Подходы, основанные на кластерах, способствуют постоянному совершенствованию качества, что делает их актуальными для будущих внедрений.
Специфика группировки для узкоспециализированных текстов
Для эффективной работы с тематическими материалами стоит применять метод семантического анализа. Он включает в себя изучение значений слов и их взаимосвязей. Такой подход позволит установить подходящие комбинации в терминах, так как однозначность может варьироваться в зависимости от области применения. Поэтому взаимодействие между терминами необходимо рассматривать в контексте.
Необходима также четкая структура текстов, что значительно облегчает работу с ними. Для этого подойдут группировки по уровням сложности или по конкретным подтемам. Не следует забывать о единообразии в использовании терминов. Это включает согласование терминологии и стиля, что предотвращает путаницу и повышает восприятие текста.
Сравнение терминов с аналогами на других языках также может служить полезным инструментом. При этом важно учитывать нюансы значения, так как прямой перевод может не всегда быть уместен. Использование переведенных терминов часто требует адаптации. Следует создать глоссарий, включающий ключевые понятия, и использовать его в качестве справочного материала.
Рекомендуется уделить внимание контексту применения терминов. Например, в научных и технических текстах могут использоваться специфические обозначения, отличающиеся от обычной лексики. Это может касаться как значений, так и формулировок, обладающих особенными признаками в данной области.
Завершая, можно отметить, что создание эффективных группировок требует постоянного анализа и пересмотра используемой терминологии. Систематическую работу с терминами следует сочетать с глубоким погружением в предметную область, что обеспечит точность и уместность выбранных выражений.
Кластеризация текстов: методы и алгоритмы
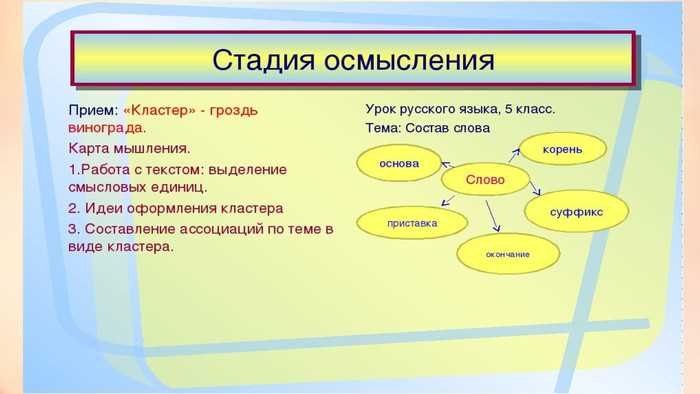
Классификация документов может быть реализована различными способами, каждый из которых имеет свои достоинства. Наиболее распространенные методы включают иерархическую агломерацию, метод K-средних и DBSCAN.
Метод иерархической агломерации создает древа, где каждая ветвь соответствует группе документов. Этот способ позволяет детально визуализировать связи между текстами, однако требует значительных вычислительных ресурсов при большом объеме данных.
K-средние представляют собой алгоритм, который делит данные на K заранее определенных групп. После первоначального выбора центров групп алгоритм итеративно обновляет центры, пока не будет достигнуто сходимости. Этот подход удобен для обработки больших массивов информации, но может быть чувствителен к выбору начальных центров.
DBSCAN работает на основе плотности данных. Он выделяет области с высокой плотностью точек и игнорирует выбросы. Преимущество данного алгоритма заключается в способности определять группы произвольной формы и работать с шумом в данных.
Для выбора оптимальной стратегии следует учитывать характеристики набора текстов, такие как его размер, степень шумности и распределение тематики. Применение различных метрик, например, косинусного сходства или расстояния Жаккара, поможет в более точном определении сходства между документами.
Оценка качества классификации может производиться с помощью индексов, таких как силуэт, который измеряет, насколько близки объекты внутри одной группы по сравнению с другими. Это помогает определить, насколько хорошо выделяются группы и пойдут ли они на пользу анализу контента.
Ключевым аспектом является предобработка текстов: токенизация, удаление стоп-слов и стемминг. Это помогает минимизировать шум и повысить качество кластеризации, позволяя сосредоточиться на значимых характеристиках контента.
Роль кластеров в улучшении качества перевода
Систематизация лексики и концепций через группировку позволяет значительно повысить точность и согласованность материалов. Применение стратегий, основанных на сегментации, способствует лучшему хранению информации.
Важные аспекты использования группировок:
- Снижение неоднозначности: объединяя слова с близкими значениями, удается улучшить выбор правильных эквивалентов.
- Ускорение обработки: доступ к семантически схожим конструкциям сокращает время на поиск и адаптацию текстов.
- Улучшение стилистической консистентности: схожие выражения, собранные вместе, позволяют соблюдать единый стиль и тональность.
Группы могут быть основаны на темах, категориях или контексте. Это позволяет создавать адаптированные подходы к различным стилям и аудиториям. К примеру:
- Составление тематических блоков для специфических секторов (медицинский, технический, юридический).
- Использование вариантов перевода в зависимости от функциональных особенностей (официальные документы, художественные тексты).
Для повышения уровня качества важно учитывать следующее:
- Регулярный анализ группированных единиц на предмет актуальности и применения.
- Практика приложения альтернативных формулировок для создания многообразия.
- Включение обратной связи от пользователей для корректировки и улучшения общей системы.
Таким образом, применение сегментации не только упрощает процесс работы с текстами, но и способствует созданию более целостной и связной информации, что оценят как специалисты в области, так и конечные читатели.
Создание кластеров для выделения терминологии
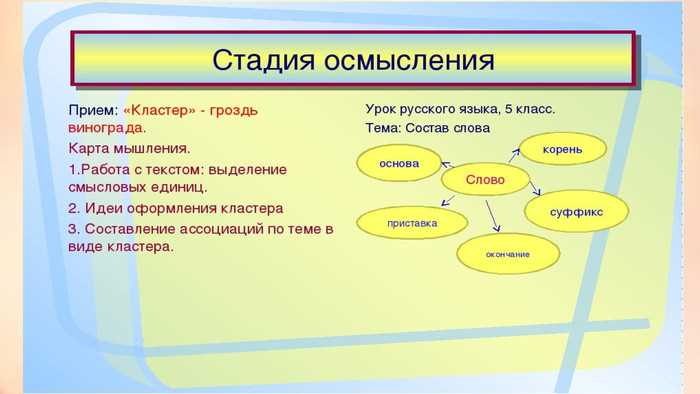
Формирование тематических групп для выделения специализированной лексики требует проработанного подхода. Важно учитывать контекст, в котором будет использоваться терминология. Начните с создания списка слов и фраз, относящихся к вашей теме. Это поможет вам понять, какие термины наиболее актуальны и востребованы.
После начального сбора информации классифицируйте термины по категориям. Например, выделите группы по функциям, назначениям или аспектам. Использование визуальных инструментов, таких как майнд-карты или таблицы, может значительно облегчить процесс упорядочивания данных.
Каждую группу следует детально проанализировать. Определите синонимы, антонимы и родственные слова, чтобы расширить понимание термина. Это даст возможность не только глубже проникнуться тематикой, но и обогатить словарный запас.
Обратите внимание на примеры употребления. Включите случаи из специализированной литературы, научных статей или профессиональных публикаций. Это позволит вам увидеть, как термин используется на практике и в каком контексте он наиболее уместен.
Также рекомендуется привлекать экспертов в конкретной области. Обсуждение со специалистами поможет прояснить нюансы и выявить новые определения, которые могут быть не очевидны изначально.
Регулярно обновляйте созданные списки. Темы и термины могут меняться, и важно следить за актуальностью используемой информации. Проверяйте обновления в источниках и вносите изменения в свою работу.
В итоге, создание эффективных групп для определения терминологии – это процесс, требующий системности, гибкости и глубокого анализа. Структурированный подход позволит избежать путаницы и повысит точность работы с текстами.
Инструменты для работы с кластеризацией текстов
Для группировки текстовых данных применяются различные приложения и библиотеки, которые обеспечивают необходимую функциональность. Рассмотрим несколько популярных инструментов.
scikit-learn – одна из наиболее распространенных библиотек на Python. Она включает алгоритмы для машинного обучения и предоставляет функционал для текстовой обработки. В частности, используются методы векторизации, такие как TF-IDF и CountVectorizer, а также алгоритмы, как K-Means для разделения текстов на кластеры.
NLTK (Natural Language Toolkit) подходит для предобработки данных. Он включает в себя средства для токенизации, стемминга и лемматизации, позволяя подготовить тексты к дальнейшему анализу. Эта библиотека идеально подходит для начальной обработки текстов перед кластеризацией.
spaCy – еще один мощный инструмент для обработки текстов. Он поддерживает более быстрые и современные модели по сравнению с NLTK. Это делает его отличным выбором для работы с большими объемами данных. spaCy также предоставляет интерфейс для векторизации текстов, что упрощает задачу группировки.
Gensim фокусируется на тематическом моделировании и предлагает алгоритмы, такие как LDA (Latent Dirichlet Allocation) и Word2Vec. Эти подходы помогают выявить скрытые темы в текстах и группировать их по контексту, что может быть полезным для дальнейшей кластеризации.
Hugging Face Transformers предоставляет доступ к современным моделям на основе глубокого обучения. Используя предобученные модели, такие как BERT, можно получать векторные представления текстов с высоким качеством, что значительно улучшает результаты кластеризации.
Комбинация этих инструментов позволяет эффективно работать с текстовыми данными, обеспечивая качественную предварительную обработку и подбор методов для кластеризации. Выбор подходящего инструмента зависит от специфики задачи, объема данных и требуемой точности.
Проблемы и ограничения кластерного подхода
При группировке данных и сведений возникают специфические сложности. Основная из них связана с неоднозначностью интерпретации смыслов терминов. Одно и то же слово может иметь разные значения, зависящие от контекста. Это затрудняет объединение информации в единые группы.
Также существует риск потери контекста. Основание для объединения может исключать важные нюансы, что приводит к искажению сути информации. Использование слишком широких категорий может стать причиной объединения несопоставимых элементов, что разрушает логику обработки.
Процесс настройки параметров анализа требует высокой квалификации. Специалисты должны не только понимать методологию, но и иметь опыт работы с различными типами данных, чтобы избежать ошибок при группировке. Каждый параметр может существенно влиять на результат, поэтому настройка требует тщательного анализа.
Технологические ограничения также способствуют неэффективности. Некоторые инструменты могут иметь ограниченные возможности по обработке больших объемов данных, что сказывается на времени и ресурсах, необходимых для выполнения анализа.
Кроме того, индивидуальные особенности субъектов могут нейтрализовать ожидаемую выгоду от применения данного метода. Разные группы пользователей могут иметь уникальные предпочтения и запросы, что усложняет универсальное применение полученных результатов.
Рекомендация: перед началом использования данного метода, важно провести предварительный анализ и тестирование результатов на небольших выборках, чтобы оценить его применимость в конкретном случае.
Сравнение кластерного подхода с другими техниками
При анализе различных методов адаптации текстов важно обратить внимание на нюансы, которые влияют на качество конечного результата. Классические методы, такие как дословный и свободный варианты, имеют свои преимущества и ограничения. Дословный подход обеспечивает точность оригинала, однако часто игнорирует контекстуальные аспекты, что может привести к искажению смысла. Свободные варианты, напротив, позволяют передать общий смысл на более высоком уровне, но могут утратить некоторые детали.
Кластерный подход выделяется среди этих техник благодаря своей способности группировать схожие элементы. Такой метод позволяет работать с несколькими частями текста одновременно, что дает возможность учитывать контекст и эмоции в каждом сегменте. Это особо актуально при работе с большими объемами информации, где требуется сохранить баланс между точностью и выразительностью. К примеру, использование тематических групп помогает удерживать ключевые идеи и обеспечивает гармоничное соединение различных фрагментов.
Сравнивая кластерный метод с адаптацией на основе машинного мозга, стоит отметить, что последние часто страдают от недостатка интерпретации нюансов. Автоматизированные системы могут ошибаться в обработке сложных структур и фраз, тогда как кластерирование позволяет учитывать такие аспекты благодаря человеческому восприятию, что делает результат более близким к исходному замыслу автора.
Кроме того, совместная работа команд над проектами требует единого подхода, что обеспечивает кластерный способ. В отличие от индивидуальной работы, он позволяет использовать коллективные усилия для создания более сложных и богатых интерпретаций. В конечном итоге, применение такого метода способствует более глубокому пониманию материала и позволяет избежать многих распространенных ошибок.
Будущее кластерного подхода в переводе
В недалеком времени технологии, связанные с группировкой задач, способны трансформировать методику работы с текстами. Упрощение доступа к ресурсам и повышение качества выполнения задач обеспечивают более значимые результаты. Автоматизация процессов и внедрение искусственного интеллекта становятся основными направлениями данного подхода.
Динамичное использование инструментов позволяет создавать синергии, объединяя навыки разных специалистов. В этой связи необходима разработка программного обеспечения, способного адаптироваться к специфике каждого проекта. Системы должны учитывать индивидуальные предпочтения и особенности контента.
| Тенденции | Ожидаемые результаты |
|---|---|
| Усиление работы команд | Повышение качества работы и сокращение времени выполнения |
| Интеграция ИИ | Упрощение процессов и сокращение ошибок |
| Мобильные технологии | Доступность ресурсов в любое время и в любом месте |
Синхронизация специалистов и акцент на коллаборации обеспечивают возможность обмена опытом и наработками. Основным требованием станет создание эффективных коммуникационных платформ. Перспективы лежат в области комплексного подхода к разработке решений, что поможет лучше удовлетворять потребности клиентов.
Антимонопольные меры и поддержка инноваций со стороны государственных структур откроют новые горизонты для развития и роста. В этом контексте главное – не упустить возможности, которые предоставляет современный рынок. Разработка гибких решений обеспечит адаптацию к изменениям и максимальную результативность.